本书的内容,以没那么兴奋的旁观者视角来看,就是试图回答如何判断形如“因为……所以……”的命题的逻辑对错。
来新工作单位之前把车卖了,以示不打算在新城市久留的决心。公交车通勤的时间长且不固定,听播客的话不仅因为路上的噪音经常听不清,而且到最后推荐算法只给推炒股和键政;于是买了个平板,观其大略地读点书。
主线剧情
“因为……所以……”
本书的内容,以没那么兴奋的旁观者视角来看,就是试图回答如何判断形如“因为……所以……”的命题的逻辑对错。
作者事先不对“因为……所以……”下定义,依靠人类当前时代约定俗成的文化涵义来使用因果判断词。
说作者没有定义有点不公平,毕竟——
就畫圖的目的而言,「因果」的定義很簡單但有點隱諱:如果變項Y「聽從」X,且Y的值依據它聽到的命令而改變,則變項X是Y的原因。
——前言·思想胜过资料
但是其中的“听从”——
幾何學書籍中不會有「點」和「線」這些名詞的定義,但我們可以依據歐幾里德公理(甚至現代版本的歐幾里德公理),來回答各種查詢[3]
[3] Yet we can answer:更精確地說,在幾何學中,「點」和「線」等未定義名詞都是原詞。因果推論中的原詞是「聽從」,以箭頭表示。
——第一章·因果阶梯·几率与因果·附注3及其原文
归根到底还是诉诸普通人对日常语言的理解。
作者认为因果关系不是,我觉得可以让步成“我们当前时代对因果的理解不只是”——
- 统计相关性:“相关不意味着因果”,更重要的是相关性不具有方向;
- 逻辑蕴含算符 :虽然具有方向性,但是 本身仅表示逻辑运算 ,理性主义有余而经验主义不足;
- 原因使结果的几率提高 P(Y|X) > P(Y):作者也不敢批评得太狠,毕竟他的方法也没差太多;
- 自由意志的主观目的:本书不讨论(除了最后一章提了一嘴),甚至整个科学都不怎么讨论。
有了(各人自行理解的)因果性以后,作者认为我们可以做到三件事,由易到难:
- 描述统计变量之间的相关关系
- 评估做某事的后果
- 想象没有做/不可能发生之事假如发生的后果
从贝叶斯法则到贝叶斯网络
作者用有向图表示具有因果关系的若干变量:
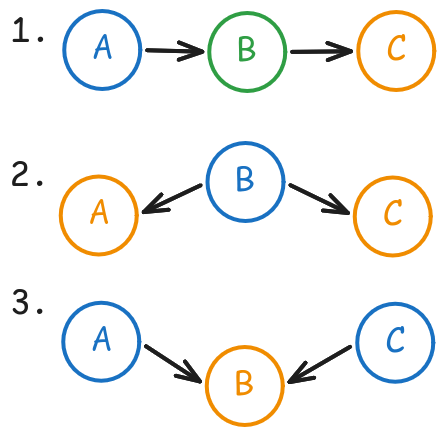
图中的每个节点都对应一个概率分布 P(A) := prob(A=a)
图中的每条箭头对应一对条件概率 P(B|A) 和 P(A|B)
根据数据计算条件概率,网络按正反两个方向更新每个节点的分布函数。以上图第一行为例:
- 正向: 用条件概率更新
- 反向: 用贝叶斯公式更新
具体技术细节第三章没再说,但是一番操作之后,最后网络的每个节点的概率分布函数会逐渐收敛。
条件化 (conditioning)
是一种可以作用在贝叶斯网络的节点 X 上的操作:只看 X 的某个取值 X=x 时,读取网络里其他各变量的联合统计分布。
复杂的网络,可以通过对上面 3 种简单网络进行组合来构成:
- 链条 (chain):整个数据集里 A 和 C 统计上不独立;对 B 做条件化处理后,A 的取值不再影响 C。B 变量称作 A 和 C 的中介 (mediation)
- 分岔 (fork):整个数据集里 A 和 C 统计上不独立;对 B 做条件化处理后,A 和 C 变得在统计上独立。B 变量称作 A 和 C 的干扰 (confounder)
- 碰撞 (collider):整个数据集里 A 和 C 统计独立;对 B 做条件化处理后,A 和 C 反而会出现负相关性。
此处的独立、相关等概念,在台版翻译中处理得不是很严谨。
(统计学中的相关 (correlation) 很多语境下仅指线性相关,这也是不严谨的来源之一)
(等一下,我怎么觉得作者自己在很多地方也无意识地假设了 z = f(x,y) = x+y)
本书作者尽力使用不同的语言来描述链式和分岔两种网络里变量的统计学特性,但是两者仅从条件化后的表现无法区分,所以需要下一章的 do 算子。
Do 算子,处理因果干扰项 (confounder)
本书中的 do 算子并不表示具有自由意志的主体 (agent) 基于目的的行为,而是特指对前文所示的贝叶斯网络的一种变换:do(X=x) 将所有指向 X 节点的箭头取消,并给这个 X 变量赋一个特定的值 x。
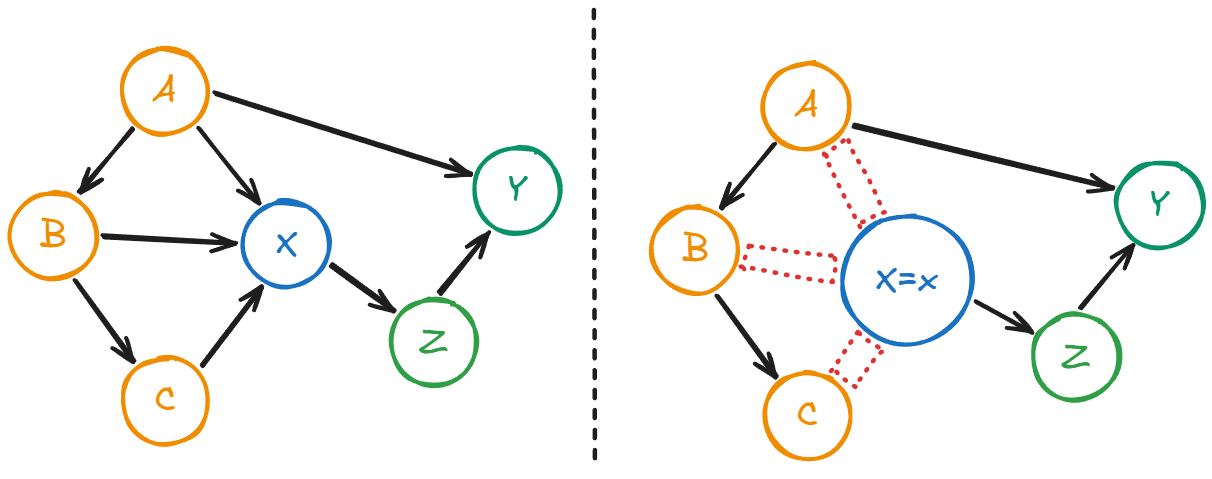
链条和分岔两种关系在执行 do 算子之后网络的结构就不一样了。
这一操作可以用来定义因果干扰项,也就是上上节中分岔网络中间的那个节点 confounder:
干擾的定義應該就是造成兩者不一致的因素:P( Y | X ) ≠ P( Y | do(X) )
——第四章·干擾與去干擾·干擾的新典範
与此同时,作者列举了几种不使用本书框架来定义因果干扰项的方式,以下各条直接摘抄自原文第四章:
- 干擾因子是同時與X和Y相關的變項
- 不可崩潰性 (non-collapsibility):從形式上說來,我們可以比較原始相對風險和以可能干擾因子調整後的相對風險。差異代表干擾,在這種狀況下,我們應該採用調整後的風險評估。如果沒有差異或差異可以忽略,則干擾不會造成問題,應該採用原始估計。(Sven Hernberg 1996)
- X(處理)和Y(結果)的干擾因子是變項Z。此變項Z(1)在整個群體中與X相關,(2)在未接受X處理的民眾中與Y相關。近幾年來又補充了一個定義:(3)Z不應該位於X和Y間的因果路徑上 (Alfredo Morabia)
- Y在未接受處理的民眾中與Z相關。(Edward Simpson 1951)
- 可交換性 (exchangeability):必須探討處理組,想像如果沒有接受處理,組內成員會出現什麼狀況,再判斷結果是否和(實際上)沒有接受處理的人相同。這時我們才能說研究中沒有干擾存在。(Sander Greenland & Jamie Robins 1986)
然后逐一批评了。
再然后就是尾巴摇狗,既然 P( Y | do(X) ) 读作“在做 X 的条件下 Y 发生的概率”,那么就把这个表达式的计算结果当作“对现实世界主动进行 X 干预后发生 Y 的可能性”。
后门准则
後門路徑是由X到Y、且以指向X的箭頭為起點的路徑。如果我們阻斷所有後門路徑(因為後門路徑容許X和Y之間存在假關聯),就可去除X和Y的干擾。
——第四章·干擾與去干擾·do運算子和後門準則
此处的“阻断”指的是条件化操作。(更具体地说,是对节点的所有值条件化之后,对每个值按照概率加权)
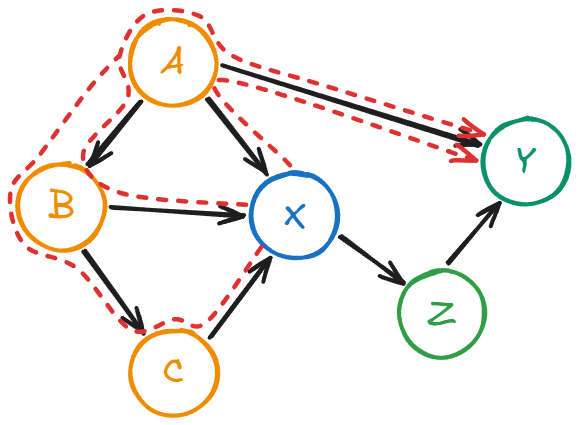
图中的网络中,X 到 Y 有 X←A→Y & X←B←A→Y & X←C←B←A→Y 三条后门路径,全都经过 A 节点。
按照作者的理论框架,
- 只需要要对 A 这一个变量做条件化处理,就可以去除 X 和 Y 之间的干扰;
- 对 A 条件化之后再对 B 做条件化就变得不必要;
- 不对 A 而对 A 以外的变量做条件化反而得不到正确结论。
——条件化并不是做得越多越好。
后门调整写成数学形式:
作者给出的例子比本笔记更简单(见下文“总结一下”里的网络),没有说如果需要同时阻断两个乃至多个节点才能应用后门准则时,这些条件化如何结合。
(如果需要用到联合概率分布的话,恐怕还是会遇到维度的诅咒)
前门准则
前門調整适用于缺少必要数据,后门路径无法阻断,因此无法用后门准则去除干扰的情况。
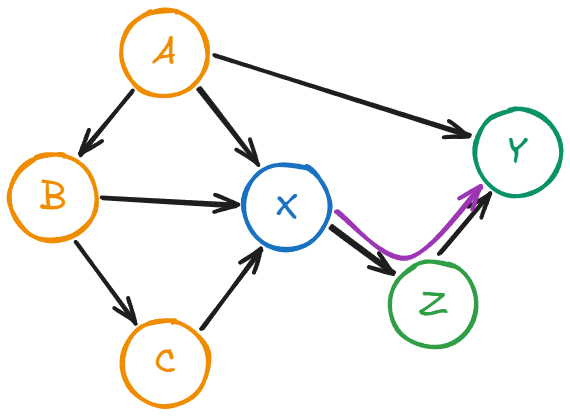
如果我们不知道 A 的数据,那么就从直接从 X 指向 Y 的路径(称为前门路径)计算 P(Y|do(X)):
原书中的前门公式有错,作者后来在本书的网站上给出了更正(公式 7.1)。
前门调整的条件还是比较严格的,以本图为例,X 和 Y 之间不能有直接的箭头,这种限制在本书中没有明确提及,需要去看《Causal Inference in Statistics: A Primer》
总结一下:公理化的 Do 运算体系
- 如果 W,Z,Y 满足链条关系 W→Z→Y,那么对于一般的 X 就有 P(Y | do(X),Z,W ) = P(Y | do(X),Z )
- 如果 Z 可以阻断 X 到 Y 的所有后门路径,那么 P(Y | do(X),Z ) = P(Y | X,Z )
- 如果 X 到 Y 没有因果路径,那么 P(Y | do(X) ) = P(Y)
书中给出的例子是下面这样一个网络(原书 Figure 7.4):
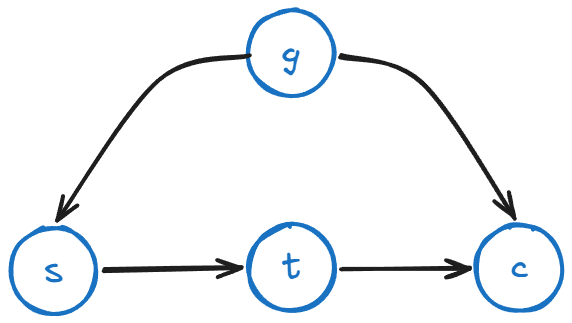
可以算出:
反事实,必要概率 PN vs. 充分概率 PS
反事实部分和前面各节的内容有明显的割裂,几乎不共用同一套语言。
因果图的语言主要发展自 Sewall Wright(第二章)。
反事实的语言主要发展自 Jerzy Neyman 和 Donald Robin 的因果模型(第八章)。作者和他的学生 Alex Balke 从 1994 年开始这方面的工作。
在我看来,要求模型能处理反事实,约等于要求模型允许把训练集中没有出现的数据当作输入。也就约等于,函数对于定量自变量具有合理的插值和延拓,对于类别自变量允许其取值是“默认/其他”。这就可以了,这本书在忙活什么呢?
我对作者的理解是,统计学研究的是N 个随机变量 , , , …, ,假设他们独立且服从同一分布 ,已知一组统计 , , …, 时,求 的分布及其相关性质。
所以作者认为,这并不能回答某个随机变量 的函数在另一个取值下的结果 ,因为上述数据没有一个是在 , , …, 的世界中得到的。例如“『我』参加高考结果只考了个 985,如果『我』当年不去参加高考,现在每月能赚多少”不能直接用“现实里高中学历/高中肄业的平均/中位数工资”来回答。
真的不能吗?我感觉只要回答这个问题,就必然在某个位置做了“某个概率分布和另一个概率分布相同”的假设,无非是这种假设是否合理的问题;批评别人不该偷换概念的同时,自己端出另一套包装起来的假设算出来的结果,有点《动物农场》的感觉……
Anyway,这套语言开始于把“假如X的值被指定為x時,Y對個體u而言所採取的值”记作
作者的计算方法是:
- 根据 的数据估计结构方程式(经常是线性的)
- 对因果模型做 算子变换
- 根据 do 算子变换过之后的新系数计算
然后引申出从 X 到 Y 的三种因果关系:充分因果、必要因果、充要因果关系:
- 作者对充分概率 PS 的定义是
- 作者对必要概率 PN 的定义是
事實上我們可以證明,我們無法以do表達式呈現。這雖然有點不可思議,但它確實以數學方式證明:反事實(第三層)在因果階梯上位於介入(第二層)之上。 ——第八章·反事實-發掘可能成真的世界·反事實與定律
这一章比较难评。
DLC:概率相关的脑筋急转弯(待补充)
- 贝叶斯先验概率的极端值:医疗检测的误诊问题
- Monty Hall 问题:三扇门的有奖竞猜
- Berkson 悖论:某两种疾病即使在一般大众中互不相关,在医院患者中却往往有关联
- Simpson 悖论:在所有分项表现更差的选择,总体上可能更好
随想
首先,这本书的目标读者是普罗大众,只看是它不够的,很多内容的详情需要去看更严肃的《Causal Inference in Statistics: A Primer》。
解决问题之前,一定要定义问题吗?
作者事先不对因果关系做严格且独立的定义,依靠人类当前时代约定俗成的文化涵义来使用因果判断词,实际上发生了概念的非法偷渡,哦不,未登记移民。
作为一个象牙塔内的学者,这涉嫌把 bug 当 feature 来用。
第四章《干扰与去干扰》中说:
如果在因果圖中找出足夠的去干擾因子,蒐集這些因子的資料,再以它們執行適當調整,就可以大膽表示已經計算出X→Y的因果效應(當然前提是因果圖有充分的科學根據)。
换句话说,本书主要解决的是“给定一个因果模型以后,如何进行因果推断”,而不是“如何仅凭观察数据证明这个因果模型就是正确的”。
如果问题是“给定这个因果图,X→Y 的因果效应能不能从现有数据中识别出来”,那么 do-calculus 等方法当然是在解决一个非常明确的问题。
但如果问题变成“这个因果图本身为什么值得相信”,那么答案显然不能再由 do-calculus 给出。因果图需要来自实验设计、领域知识、时间关系、已有科学理论,或者其他额外证据。
再比如,如果有两组研究人员根据自己对问题的理解给出了两个结构不同的因果网络,这个理论框架有办法定量地比较两个网络的表现吗,尤其是在两个网络的复杂度不同的情况下?
作者对这个问题应该算是诚实的,明确承认数据对因果关系 “profoundly dumb”,而因果问询必须结合模型假设;甚至在没有测量混杂变量时,继续收集再多数据也可能没有用,必须回去修改模型或者增加科学知识。
但是本节的小标题还是写成了问句的形式:因为我还想补充一下,哪怕做到了“先定义问题,后解决所定义的问题”,也并不意味着研究本身的质量就一定高。
我读博时的物理系会在学期中的周六上午举办一个系列科普讲座,主要目标受众是中西部的红脖 boomers 及他们的孙辈。有次轮到了隔壁理论组的老板,讲座题目是“万物的理论 (Theory of Everything)”~
啥玩意儿能当得起万物的理论这么高的帽子呢?啊对,物理;更具体一点呢?上下四方曰宇,古往今来曰宙——宇宙是 universe;万物的理论就是关于整个宇宙的性质 (quality),俩词一合并就是 universality。而 universality 是统计物理中已有定义的一个科学概念,所以我们这次讲座的主题就是 universality~
我不知道大家觉得这个思维链条 are you ok 不 ok 啊,我只觉得本正义史官有责任有义务给他记上一笔。
我个人对因果关系的一个试探性定义
略。(有人留言讨论再写)
贝叶斯公式,作为一种元数据/上下文处理器
之前写过《Bayesian 贝叶斯,从公式到世界观》,里面主要讨论的是实验科学的观测结果 Observations 和理论科学的模型参数 Parameters 之间的关系:
读这本书时有了一点新感悟:不仅是理论和现实之间,贝叶斯公式也可以用在理论内部的不同前提之下。(甚至应该说前者才是高阶用法,在理论内部游走是贝叶斯公式的应有之义。)
对于我们想判断对错的命题 Q,如果知道了某个前提 P,可以更新对 Q 正确程度的信念:
这里的关键是什么呢?就是把 Prob(Q|P) 和 Prob(Q) 当成同一个东西。
本来人们的问题是“Q 是否成立”,而我们回答“在 P 成立的情况下 Q 是否成立”。
再次完成概念的非法偷渡,哦不,未登记移民——本书作者的传统艺能。
为什么能这么干呢?因为 P 在我们回答时就已知成立了,只是藏在海量的元数据/上下文当中,你提问的时候没想到这一点而已。
但是要说这种玩法完全没意义,那也不太公平。毕竟理论上只要公理给定,任何其他命题都应该要么是定理,要么是错误。但此时此刻的世界上还游荡着不少猜想,搞不好还有矛盾。
现实中很多证明是很困难的,甚至知道如何验证一份证明,并不一定意味着能直接构造出证明本身。再往下就是 P = NP? 问题了,不在本文的讨论范围之内。
总之就是说,在探索 Q 的过程中,上下文出现新的前提 P 是很有可能的,那么让这笔新的信息流入现有的知识库,成为元数据,确实需要一定的操作流程。贝叶斯公式提供了此类操作流程的一种可行的原理。
这就让人想到《什么是智能≠智能是什么》中对 DIKW 模型的讨论:
Dfor Data 数据Ifor Information 信息Kfor Knowledge 知识Wfor Wisdom 智慧
四个层次,前一层都是后一层的基础,后一层都是对前一层的理解。
这层与层之间看似并没有插入额外的内容,智慧可以直接由笔画构成。但是我们一层层理解的深入,其实是不自觉地借用了我们当前社会约定俗成的解读方式。
约定俗成的数据解读方式,也就是关于数据的数据,根据西方的构词法,可以叫做“元数据”(meta-data)。
历史发展的切线方向
使程度與人類相當的智慧(有時稱為「強AI」)自動化的問題。我相信因果推理是讓機器以人類語言與我們溝通,談論政治、實驗、解釋、理論、遺憾、責任、自由意志,以及義務等話題,最後自己做出道德決策的關鍵。 ——前言·思想胜过资料
我們何不放任深度學習系統發展,創造新的智慧,但不了解它的運作方式?我不能說這樣不對。在這個時代,隨意派比較占優勢。儘管如此,我還是可以說我個人不喜歡不透明系統,所以我沒興趣研究它們。
撇開個人好惡,這個人類大腦比喻還可加入一個因素。沒錯,我們容許自己對人類大腦運作不夠了解,但我們還是可以和其他人溝通、向其他人學習、教導其他人,以及用我們自己的因果語言鼓勵其他人,因為我們的大腦運作方式相同。如果機器人都像AlphaGo一樣不透明,我們就沒辦法跟其他人對話,這樣就太可惜了。
——第十章·大數據、人工智慧與大問題·強AI和自由意志
本书出版于 2018 年,文稿的写作应该更早;本读书笔记写于 2026 年。在此期间:
- 2017 年 6 月 12 日,论文《Attention is All You Need》在 arxiv 上线,transformer 架构被发明。
- 2022 年 11 月 30 日,ChatGPT 正式上线。
- 2023 年 6 月,OpenAI 的安全研究负责人 Lilian Weng 发表了一篇极具影响力的博客《LLM-Powered Autonomous Agents》(LLM驱动的自主智能体)。
- 2026 年 5 月,Claude Code 正式推出 Agent View 功能,支持开发者在单一界面中调度多个 AI 代理人
- ……
在没有显式使用因果推理的情况下,大语言模型 LLM 确实已经可以“以人類語言與我們溝通,談論政治、實驗、解釋、理論、遺憾、責任、自由意志,以及義務等話題”,甚至可以在个别环境采取行动改变外部世界了。
可以说作者没有想到,只要数据量和算力管够,在底层的数据级别找到的数学规律,可以涌现出信息、知识,甚至智慧级别的有效内容。
但是本文无意过多批评作者对未来的不够乐观,因为这种事后诸葛亮式的批评有自作聪明的嫌疑,常见于说书先生、自媒体、(部分)中学老师等已经退出新知识、新文化一线生产者角色的人。
以今日的状况外推到将来固然经常不够乐观,但是以今日的增长斜率外推到将来也有可能过于乐观。
因为如果是那样的话,这个世界的一切科学早就应该被搞 ab initio 第一性原理计算的理论 (?) 物理学家爆破了,哪还轮得到现在这帮搞计算机视觉的玩什么 world model(逃),更别说之前金融市场炒作失败的元宇宙概念了。
科研民工应该知道,科学史上重大的成果固然志存高远,但也仰赖其具体实现恰好能被当时技术的边际进步兜底的幸运;而那些野心过大,当前技术和算力无法匹配的项目,往往无疾而终,很少给局外人留下经验教训,也就形成了“悲观者正确,乐观者成功”的幸存者偏差。
在今天这个整个科学界都有断(徒)子绝(徒)孙的可能性的时刻,还没有拿到终身教职的底层科研民工,既要有在泡沫破裂之前坚信价值规律终将回归的定力,也要储备足够的业务能力,为了活到价值回归的那一天。
本文收录于以下合集: